Understanding Deep Learning Requires Rethinking Generalization
我知道我可能会错得离谱,又好奇为什么其他聪明的人对事情的认识与我不同,这促使我既从自己的视角看问题,也从别人的视角看问题。
—— 瑞·达利欧《原则》
论文:Understanding deep learning requires rethinking generalization。文中配图来自该论文。
第一次读 ML 的论文,可能比较粗糙,有问题多指教。
问题是:模型参数这么大,远超题目数量,完全可以背下来题目,所以理论上应该很容易“过拟合”,好的设计,为什么在大部分情况下,在训练集和测试集上表现出很小的差异。有一些设计又很容易导致“过拟合”呢。所以什么是“泛化”呢。
随机数据也能背下来
作者开始做实验,以这个CIFAR-10 识别为例子,修改 label 和输入图片,有这么几个实验
- 真实数据集,啥也没改
- 部分损坏的标签,狗的图片标成猫,以概率 p 独立替换为均匀随机类别
- 完全随机标签,完全随机
- 打乱像素:选择一个随机的像素排列,然后应用在训练和测试的所有图像
- 随机打乱:对每个图像使用不同的随机排列
- 直接用高斯分布(均值和方差与原始数据集匹配),为每个图生成随机像素
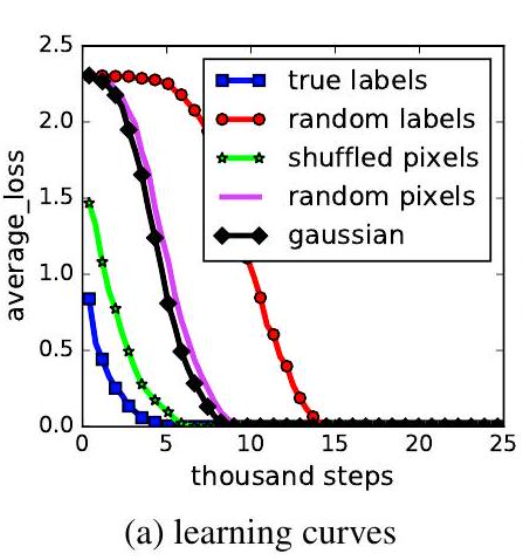
即使完全随机的 label,模型也能在训练集上拟合到 100%。同时这个图很有意思,真实数据集,下降是最快的,random labels 是最慢的。
另一方面高斯(也就是图片完全是随机生成)的,下降的反而比 random label (这个至少图像是真实的)快。
然后切换到 ImageNet,这个数据集大约有 100w 的图片。也全部给他们随机标签,模型依旧能训练到 95% 的训练集准确率。甚至进一步调参,有可能模型在这个完全随机的 label 下,也能达成 loss 0.
总之传统思路是,模型容量不能太大,不容易记住数据集,所以能泛化。但这篇实验证明,它确实可以背题(哪怕是 100w 道题),但另一方面,他又在真实数据集上展现出很强的”泛化“能力。
再进一步,作者进行那个只是打乱部分 label 的实验,从 0,0.1 .. → 1,模型都能在训练集上完成 100% 准确率,说明”学习“和”过拟合“两件事可能同时在发生。
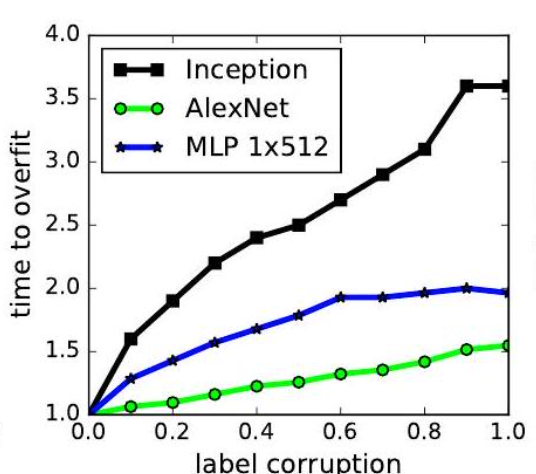
但另一方面,随着混乱标签的增多,模型收敛需要的时间在增加。
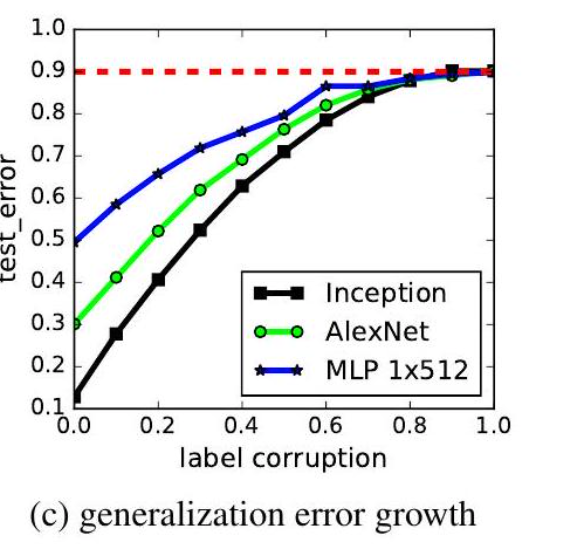
正则化能解释泛化吗?
更进一步,作者开了“正则化”(就是所谓,防止“过拟合“的常见手段),因为这是对抗”过拟合“的常见手段。经典观点是,模型太大了,太自由了,用一些手段限制一下求解空间,这样”有效空间“变小,更难过拟合了。
这个图展示的是“泛化”gap = test error - train error = test error(因为 train 都是 0),最后收敛于 10% 的准确率是因为 CIFAR-10 只有 10 类,基本等于瞎猜。
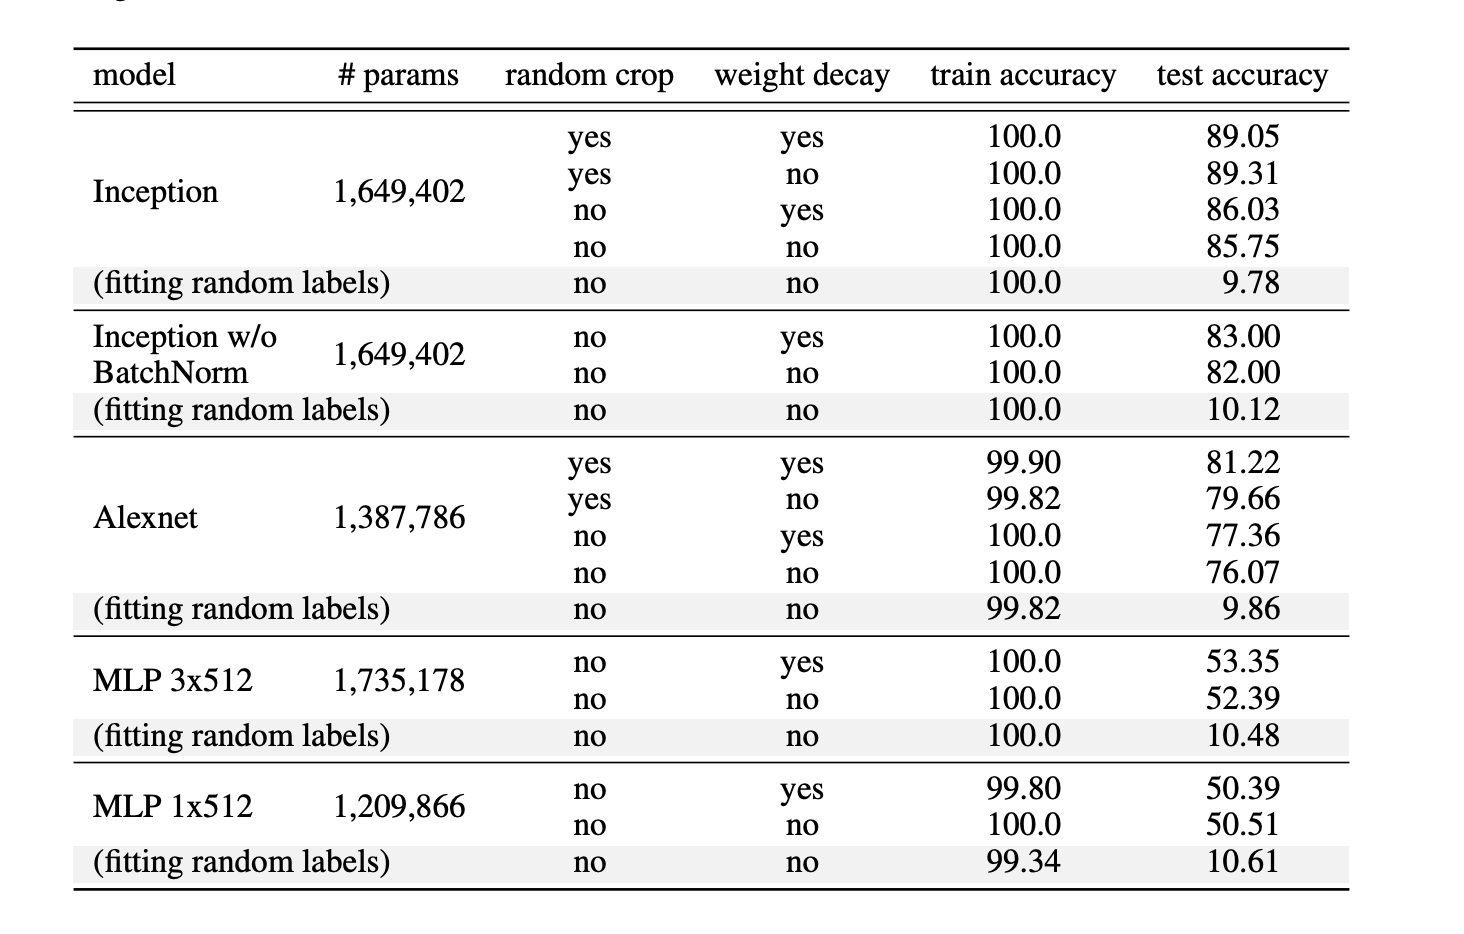
(随机裁剪,weight decay) yes or no。比如Inception,不管怎么开,train 上都能 100%。但是全部关闭正则化,test 准确率确实下降了,不过没有”崩溃“到随机的地步。这里还有一个细节是,random crop 的作用似乎比 weight decay 大一点。
模型能同时在正确数据集和完全随机数据集上做到 100% 的训练准确率,但前者测试集 85% 准确率,而后者则会退化到 10%。
另一方面来自模型架构,虽然大家训练集都能做到 100%,但是测试集上,大家表现就不太一样了,MLP 表现明显不如 AlexNet 这些,测试集上只有 50% 的准确率。所以架构本身也带来了一些“约束”。
然后是另一个防止“过拟合”的高招,就是 early stop,怕模型学太多,学进去了,过拟合了。论文在 image net 上确实观察到了这种情况,但在 CIFAR 10 上,没有观察到比较显著的效果。
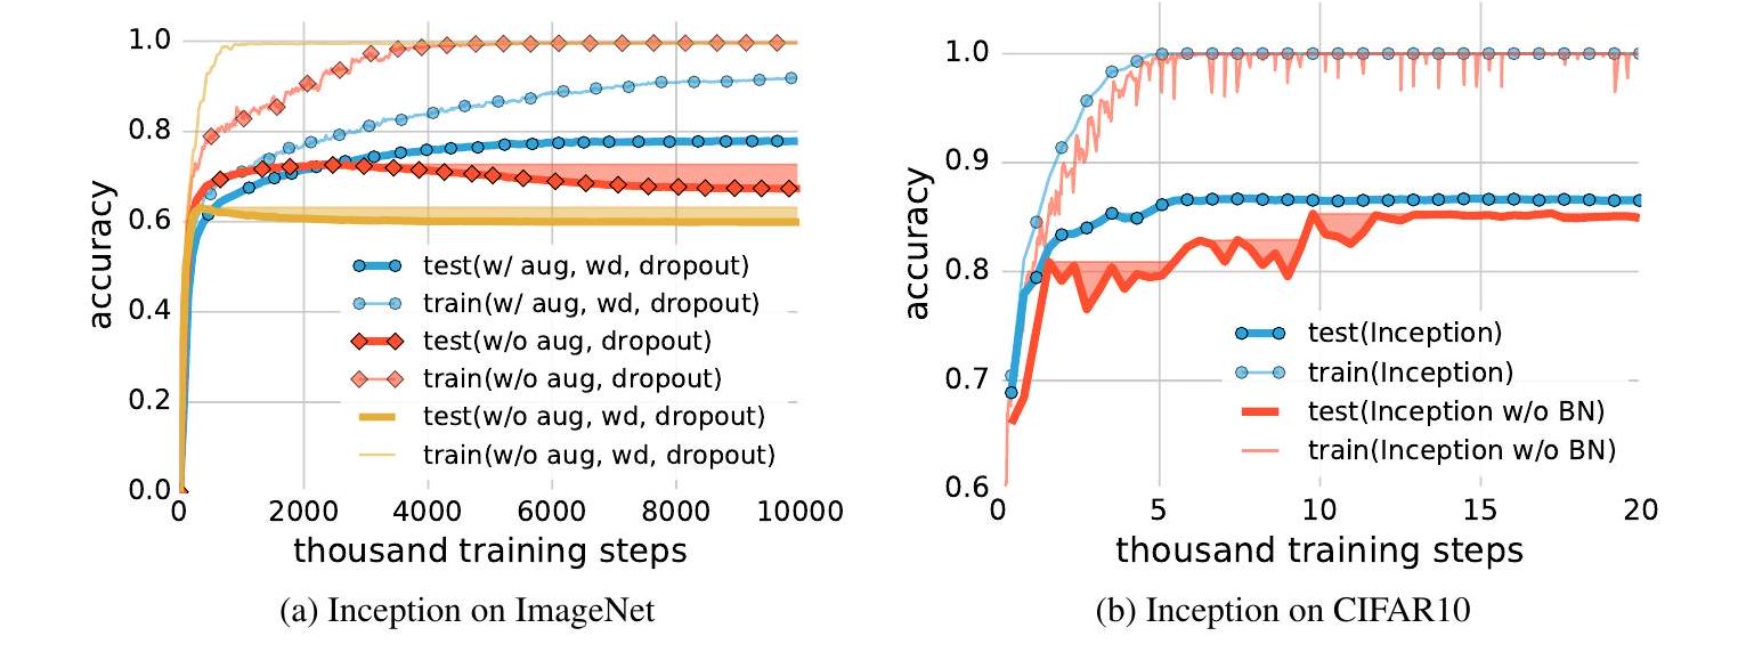
然后是 BatchNorm,让结构输出稳定一些,让优化稳定一些。所以论文把这个结构从Inception上下掉了,结果不仅训练变慢了,最终效果也确实变差了一点。说明 BatchNorm 还是有点用的。
总之一句话,这些正则化手段可以帮助模型“泛化”,但不是模型“泛化”其根本原因。因为即使全部不开,模型表现也还不错。
两层 ReLU 网络也能记住数据
之后论文开始论证一个观点,只要参数数量和样本数量在一个量级,哪怕是个两层的 ReLU 网络,也足够记住任意有限数据集。这里证明的是模型参数本身表达力。
对任意 n 个位于 R^d 中的不同样本,存在一个两层 ReLU 网络,只需要 2n+d 个参数,就可以在这 n 个样本上表示任意函数
实际上就是一个函数,它只要能不冲突地做到 f(x_i) = y_i,它就有硬背数据集的能力。而且现代神经网络的参数量远超这个参数量,那就更具有能力了(实验下来也是这样的)。
这个论证等我消化一下,反正大概结论是这样的。
优化器会选择哪个解?
这样问题就变成,神经网络可以有超级多的参数组合可能做到训练集 100% 准确率,他们也可能会具备不同的测试集准确率,那么优化器会达到哪个呢?并且到达的那个似乎看起来还不错,而不是到了过拟合的那个?
这个时候又有理论了,就是去看这个 loss landscape,虽然大家都是 0,但是大家周围的“锐度”可能不同,传统理论认为附近平整的点,好于附近陡峭的点。或者说,参数稍微变动一点点,loss 波动就大幅波动的点,可能更差劲。
论文又给了一个很简单的反例:在线性模型里,这套 “flat minima 更好” 的解释甚至没法区分这些解。假设 在线性模型下,loss 是最普通的平方误差,满足“过拟合”的参数可以有无穷多个,而且不管选哪个,在 loss 的二阶导下,它们的“锐度”都一样,根本区分不了。
所以到底是什么决定了优化器去到最终选哪个解呢?虽然它面对无限多的路径,但因为 sgd 跟着梯度走,所以固定样本 + loss 一定会给 SGD 一个固定的路走,它被自己的“下降”方式限制住了探索空间。
在线性模型下,这个落点甚至可以确定性的算出来,比如只有一个样本的训练集,x 是(1,1),y 是1,模型就是 w1x1 + w2x2,loss 用 mse,梯度一定沿着(1,1)这个方向走,等它触碰到 loss 0 的时候停下,这个时候就是 SGD 选择的“解”。
虽然 w1 + w2 =1 就行,比如(0,1),(1,0)这条线上的任意点,但 SGD 最终会选择(0.5,0.5)这个点。选到的这个线性解,正好是模长最小的那一个。
没有正则化,也没有其他 hint,SGD 自己的更新方式天生产生了这种偏好。
模型虽然具备完全过拟合的能力,但在数据的加持下,优化会天然偏爱某一类解。
数据的表示方式也很重要
或者换一个角度,这个解是“样本的某种组合记忆”,用样本的相似度(内积),也就是说,最终的参数 w 本身就是训练样本的某种线性组合。也就是从找“参数”变成了”kernel“解。
或者换个说法,不是去探索参数的空间,而是用样本反推参数应该长什么样。
所以某种程度上,泛化很大程度上取决于数据本身的数据结构,数据本身的偏好,优化器的偏好。
所以作者在 mnist cifar10 两个数据集上尝试了 kernel 解,不带任何的正则,可以轻松做到 train error =0,同时 test error 很低。
同时作者又做了一个实验,预先根据一些先验,做更好的 feature,比如 mnist 上做 wavelet,cifar10 做随机卷积特征,同样的 kernel 解,test error 会更低。
这个又打脸了最小模长(数值最小?)的理论,因为这样做完后,模长反而上涨了。
所以数据的“表达”方式很重要, 数据先被表示成什么样的空间,再加上 optimizer 在这个空间里偏向什么样的解,两者共同决定最终的泛化。